- 本文地址: https://www.laruence.com/2026/09/16/6626.html
- 转载请注明出处
GPT-6 Astra 发布以来最火的是建模。它在 Blender 里自己写脚本、跑渲染、看效果、改一改,然后一栋住宅就建好了。
当然,也有人说,异形结构还不行,细节问题很多,中看不中用,等等。
了解的同学大概知道,我过去几年开始创业做如视(Realsee),而我们做的是实景三维重建。大家在贝壳找房上看到的 VR 看房、美团上看到的餐厅预订 VR 等,就是我们的工作。所以这几天我做了一组测试:给定真实采集的空间数据,Astra 的重建能力到什么程度,边界在哪。
案例:住宅
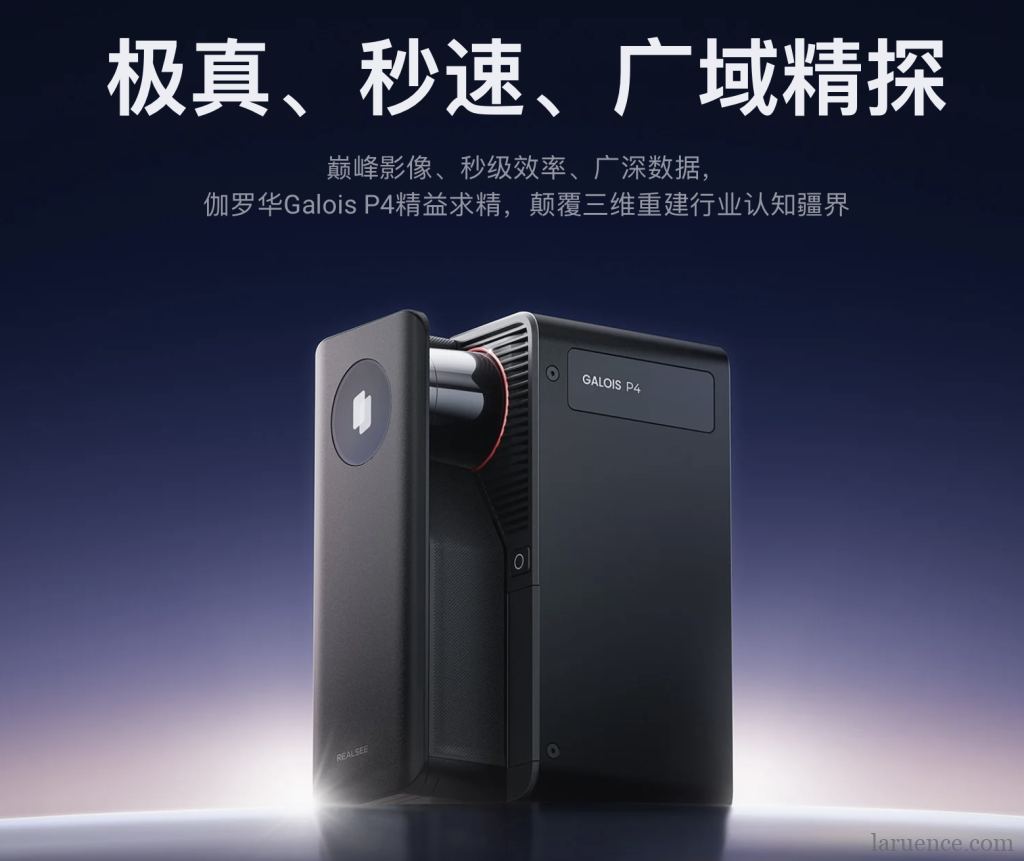
我挑选了一套新房样板间,采用如视伽罗华 P4 采集, 它是我们设计生产的架站式激光扫描仪,它的特点是会采集最高高达32K的全景图,它长这样(大家如果在贝壳卖过房子,应该会见过它):
数据包括 24K HDR 全景图、高精度点云、Mesh 等 16 种数据(4.3GB):
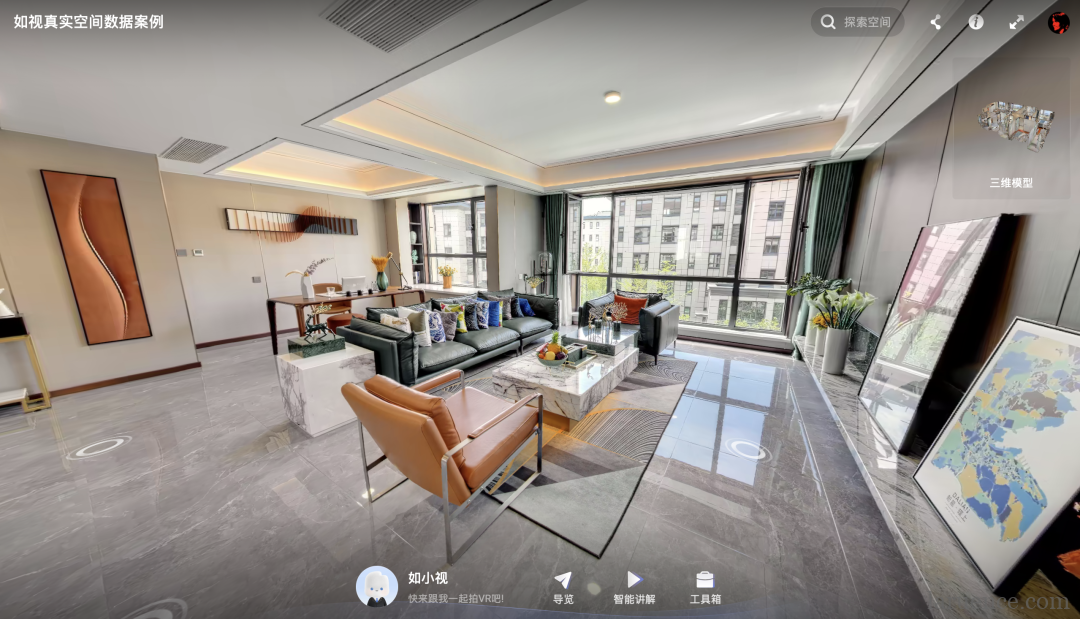
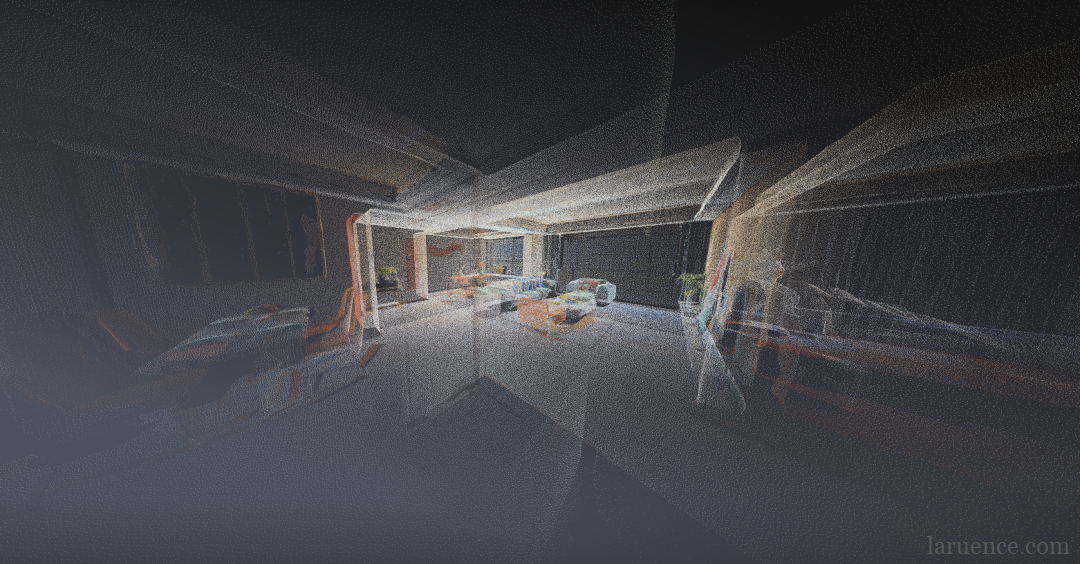
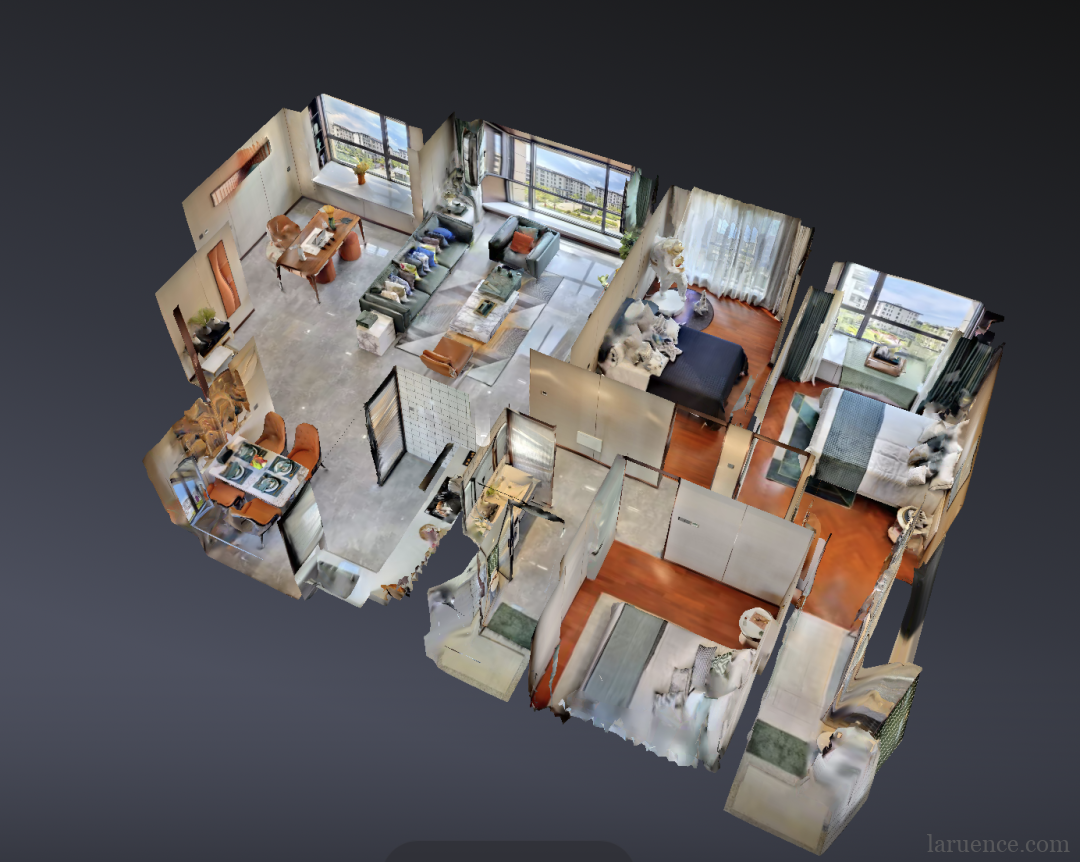
我把伽罗华 P4 采集和产出的 16 类数据(全景图、HDR Raw、深度图、六视图、Mesh、点云、位姿、3DGS、物品识别、户型图、CAD、反射率、多光谱等)一次性给到 GPT,由它判断“需要哪些”。GPT 的选择逻辑是按用途分工:
平面图确定房间结构 → 点云和深度约束形状 → 识别结果帮助定位物品 → 全景和截图指导造型与材质。
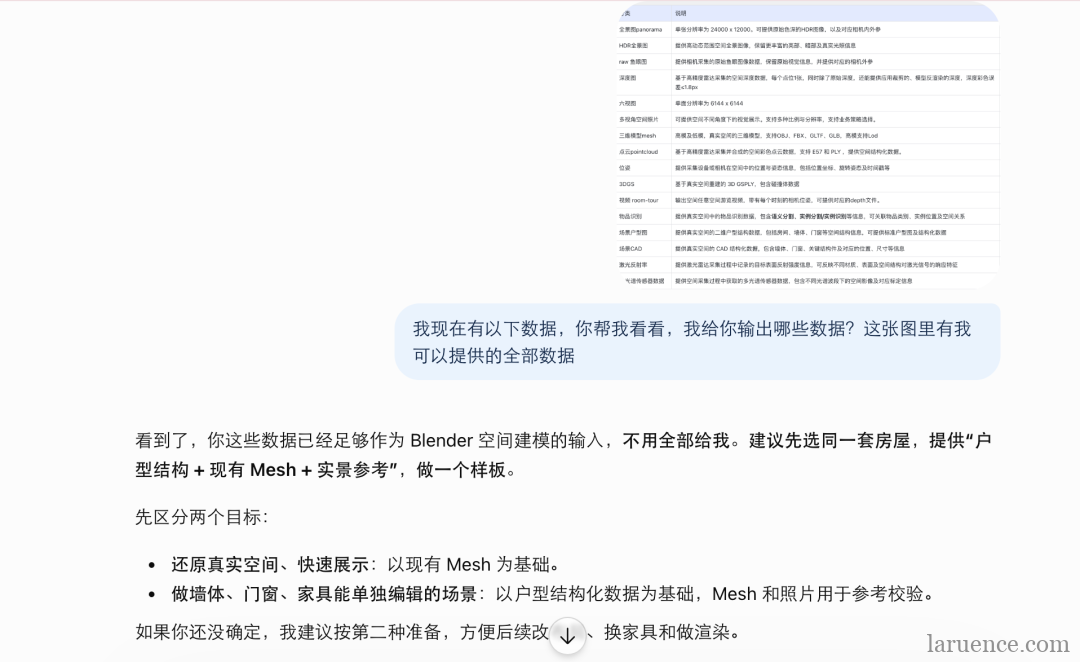
第一轮,使用“户型图 + Mesh + 户型 JSON + 模型压缩包”:
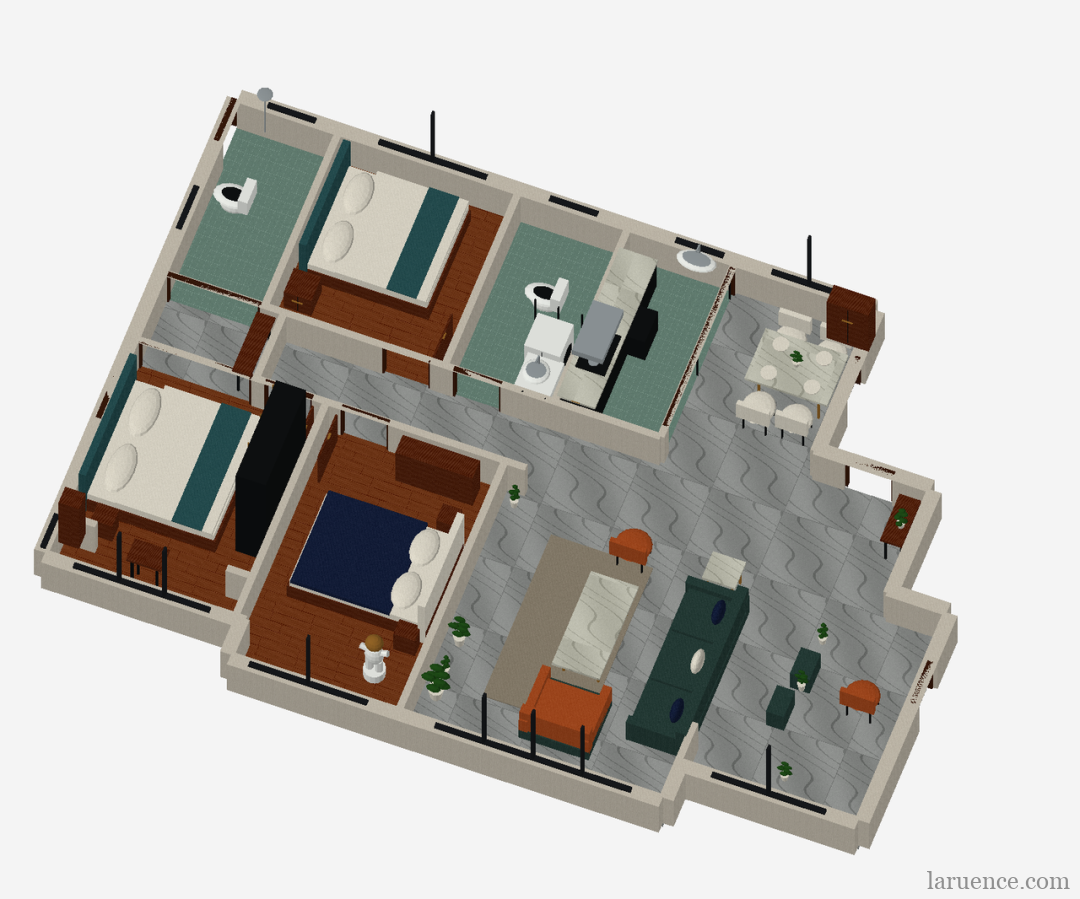
可以看到还是不太行:无论物体、户型格局、颜色还是材质,都不太对。
第二轮:补充图像、点云和深度图数据
我和 GPT 沟通生成中的问题:哪些方面还原得不好,以及它还需要哪些数据来帮助项目优化。
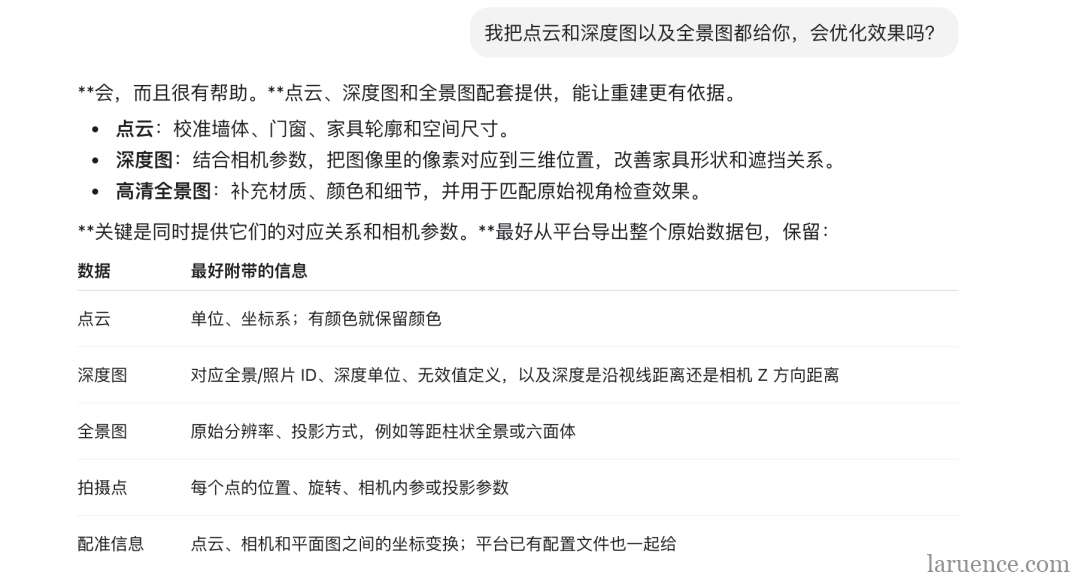
GPT 很快理解了点云、深度图和高清全景图分别能优化哪些问题。收到新的数据之后,新的输出结果比第一轮提升了很多:
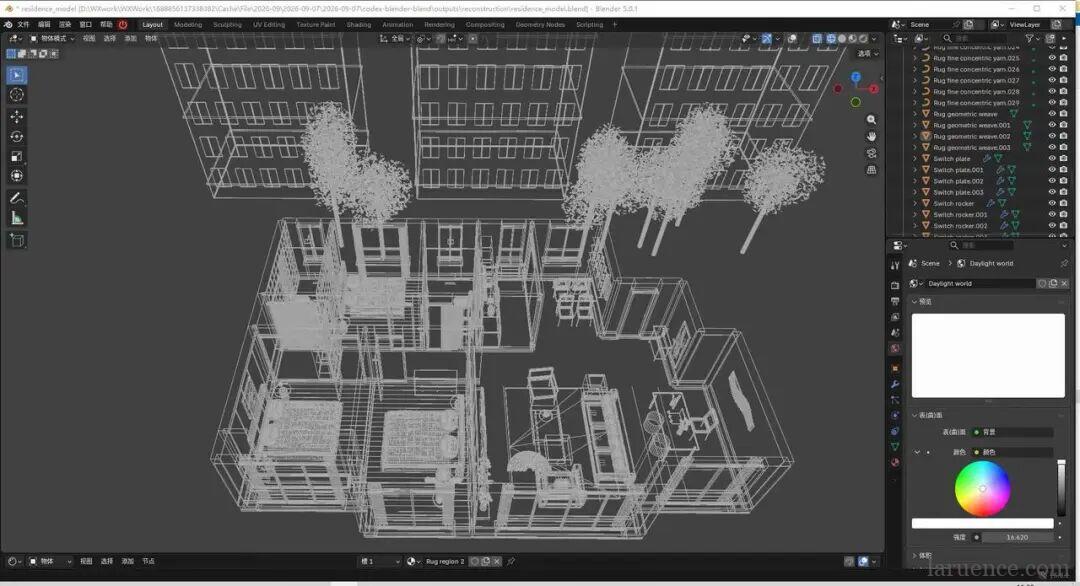
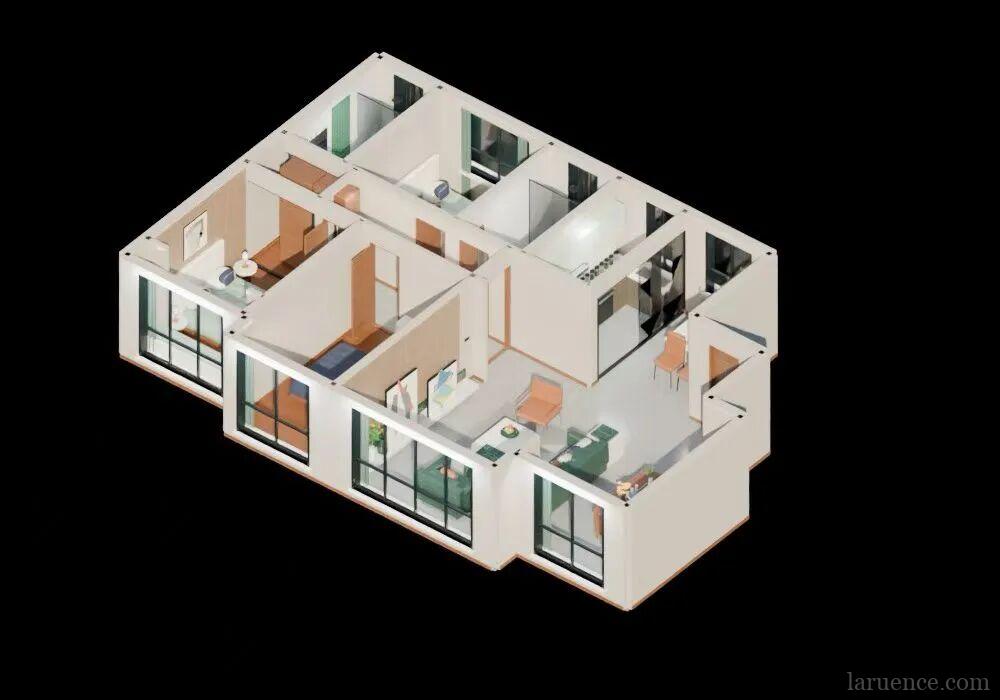
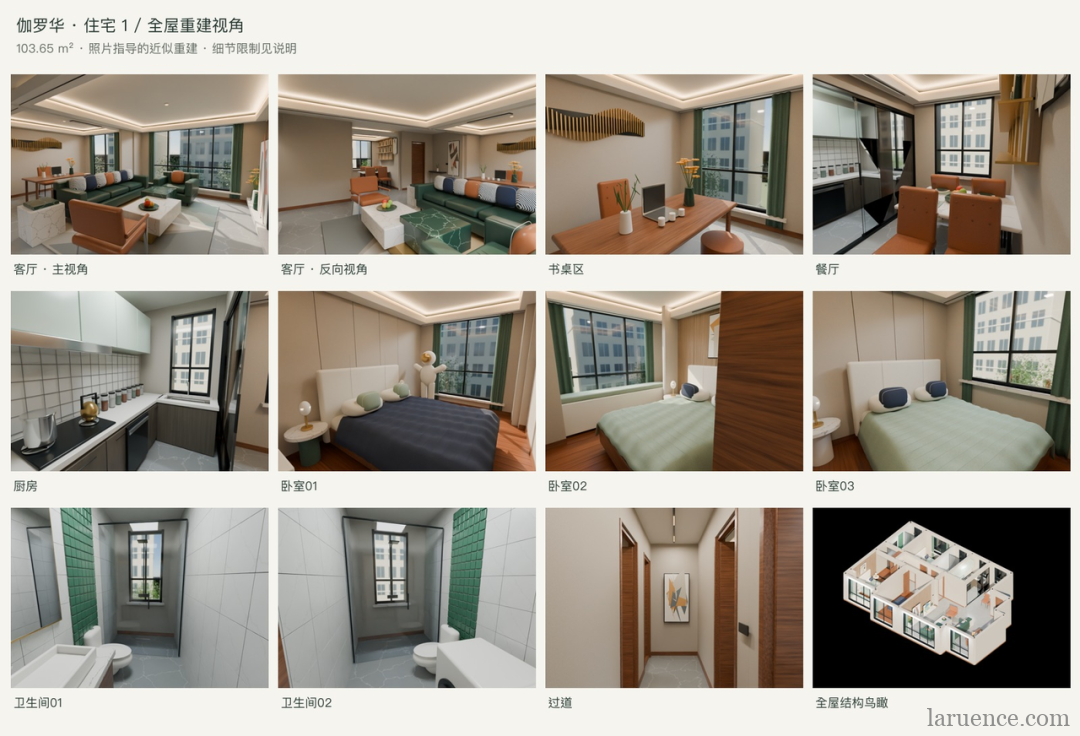
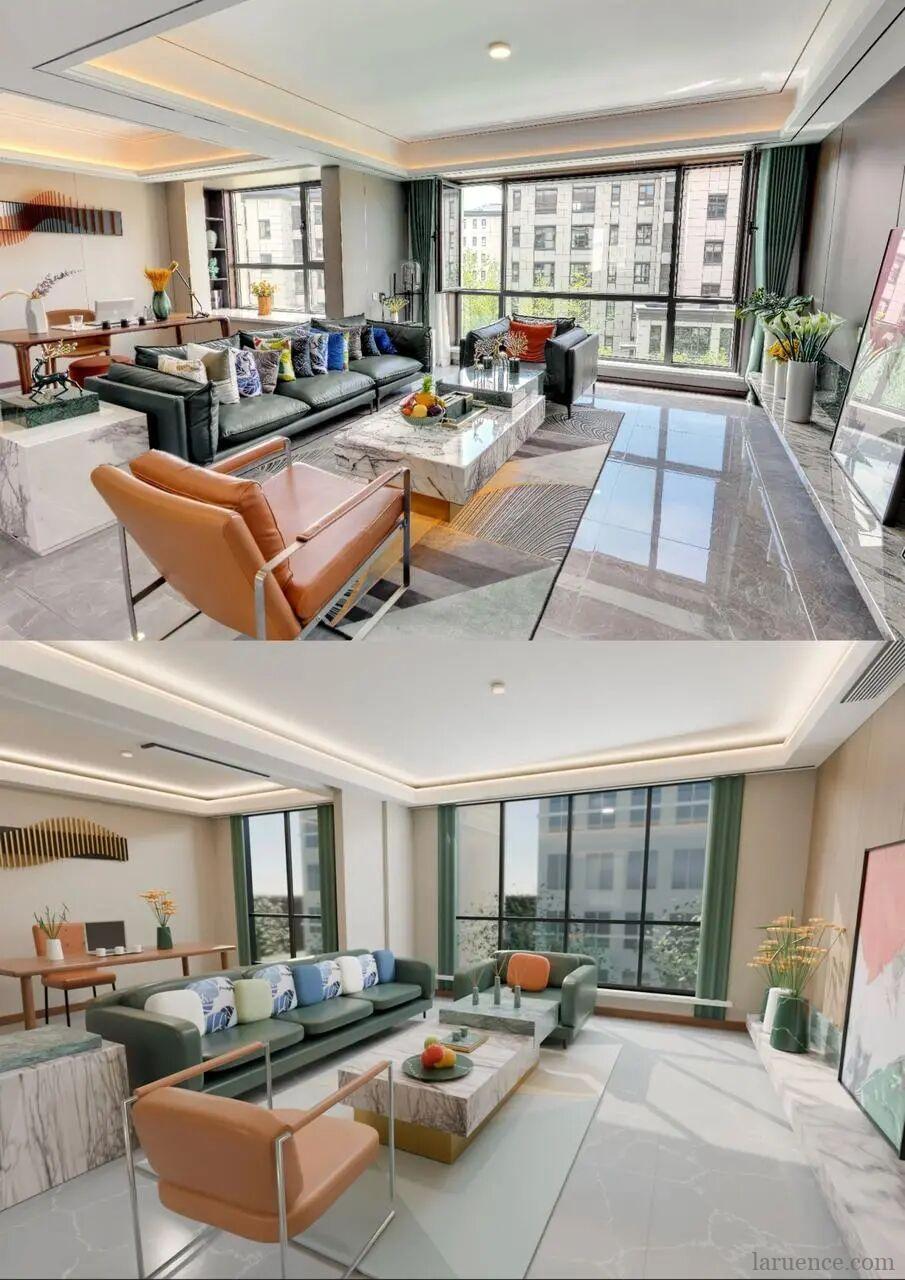
上面是伽罗华真实拍摄的 24K HDR 全景图,下面是 GPT-6 虚拟渲染出来的效果。可以看到,到这一步,整体布局、家具种类、颜色、材质、朝向都基本正确,甚至窗外景色也做到了相似。
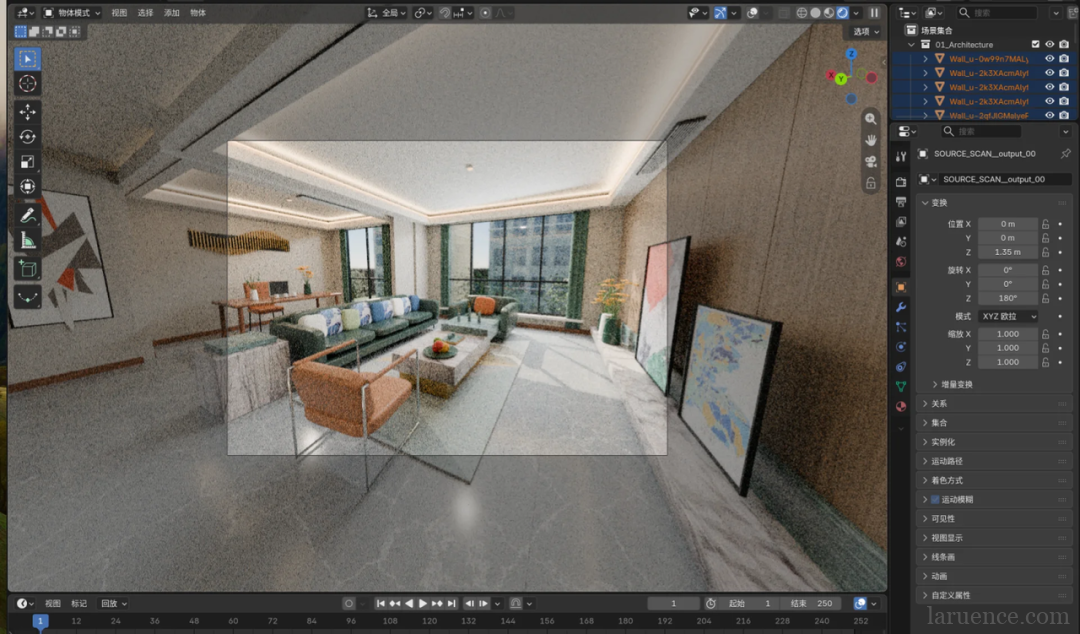
并且所有物体都有单独模型,可以拆分。我感觉每一个家居都经历了:
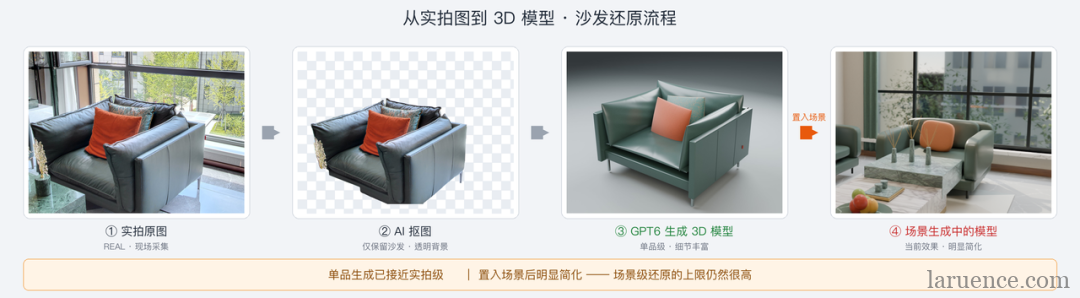
总的来说,虽然细节上还有很多小问题,但整体上乍一看已分不清虚拟和现实。非常惊艳。
一个对照实验:只给照片会怎样
那既然 Astra 这么强,丢几张照片进去不也能行么?
我也试了。即使 prompt 明确要求高精度还原,仅有全景图输入时,GPT-6 的结果仍是从图像理解出发、基于空间结构假设“猜”出来的。单个物品还好;但当大量物品在同一空间内存在确定的几何关系约束时,关系还原会混乱,整体结构和细节看起来就会很粗糙。
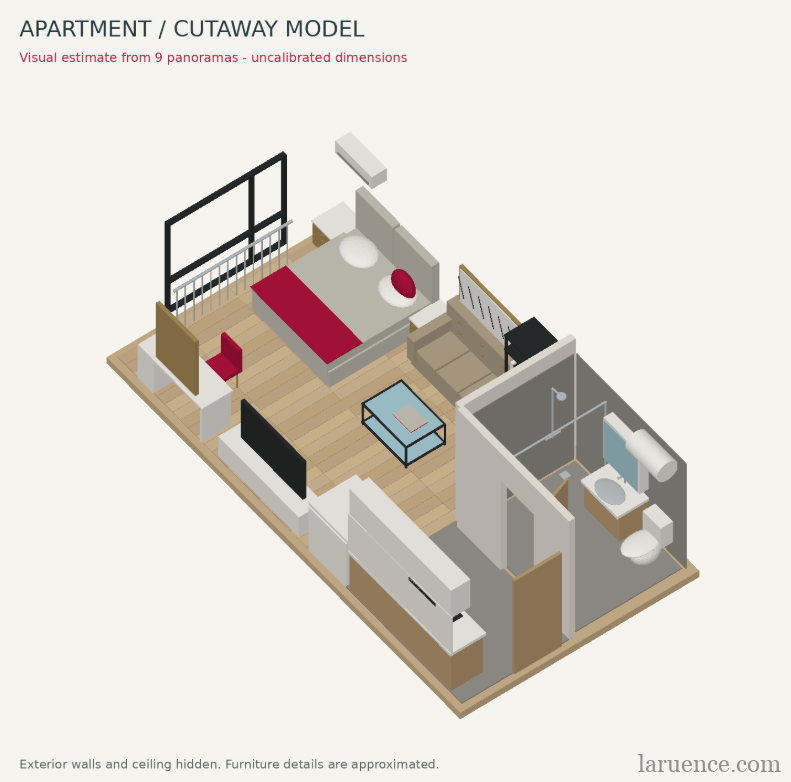
对比下来,给到 GPT-6 Astra 更多数据——精细高清图像和对应的空间点云,空间的结构、测量尺寸、图像之间的位姿、布局关系都是确定性输入,输出质量就更高了。
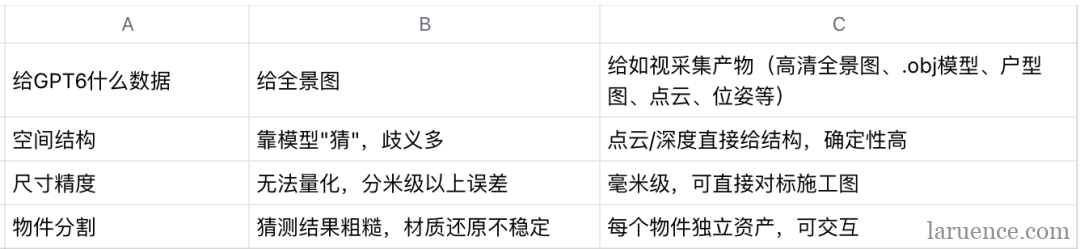
同一个模型,给它照片,它交出的是想象;给它高质量的数据,它交出的是工程。
对应到产出端,自然会带来:
- 空间结构确定性更高:激光扫描给的是物理空间的真实布局和连通关系,不是“图像推断”。Astra 建模时歧义更少,少走弯路,降低结构歧义与人工校正成本。
- 尺寸是毫米级,能直接进下游:硬件精度直接传递给模型。输出的
.blend/.usd等通用格式场景有量尺,可对接更多下游应用场景。 - 物件可分割、可替换、可导出:每个物件都是独立资产,单件换材质、做动画、导出都行。而且数据源画质够高,物件纹理来自真实扫描的多视角观测,不是 AI 臆造出来的。
这事到底“能用”在哪
凡是需要“空间数据驱动决策”的场景,数字孪生就有价值。过去卡在三个字:建模贵、周期长、精度不够用。
现在,这三个问题同时在松动。
图像可信、尺寸可信、结构可信、资产可分割——这四个词凑齐了,下游才敢接。仿真模拟、设施巡检、沉浸文旅、安全培训,包括具身智能的 Sim-ready 训练、游戏和影视创作,都能用同一份数据往下走。
最后
最有意思的地方不是“AI 会建模了”。虽然瑕疵还多,但我相信随着 AI 的快速迭代,未来都能克服。
而是:当 AI 的行动力不再是瓶颈,瓶颈会回到数据本身。
注意这里的“数据”指什么:不是“有数据就行”,而是确定性的、有尺度的、多视角的真实采集数据。模型越强,对数据质量的要求不是降低,而是升高——因为它能利用的信息维度更多了。
当然,也不排除是我的使用姿势有问题,欢迎留言指出。
最后是一个更详细的教程和案例数据下载地址:
- 教程地址:把真实空间,变成可以编辑的 Blender 模型
- 数据链接:案例数据(4.3GB)
 阅读公众号原文:《GPT-6 Astra 做实景三维重建,我拿一套住宅试了试》
Be First to Comment